Восстановление региона после отказа двух управляющих узлов
При одновременном отказе двух управляющих узлов из трёх регион теряет кворум во всех кластерах управляющего слоя, а API OpenStack становится недоступен. Восстановление принципиально отличается от замены одного узла (см. Замена управляющего узла региона): пайплайны сами по себе не восстанавливают кворум, поэтому кластеры на уцелевшем узле приводятся в рабочее состояние вручную, и только после этого узлы вводятся обратно.
Предупреждение
В течение всей процедуры регион недоступен. Восстановление занимает несколько часов и включает операции, которые выполняются вручную на уцелевшем узле.
Важно
Процедура применима, если данные на уцелевшем узле пригодны для использования. Если повреждён и уцелевший узел, выполняйте восстановление из резервной копии (см. Резервное копирование и восстановление), а не эту процедуру.
Что происходит при потере двух узлов
Поведение компонентов различается, и не все из них требуют вмешательства:
Компонент |
Состояние на уцелевшем узле |
Требуется |
|---|---|---|
Galera |
при штатном выводе узлов остаётся |
восстановление кластера, ограниченное уцелевшим узлом |
RabbitMQ |
приложение |
удаление отказавших узлов из кластера |
etcd |
кворум потерян, обращения к API завершаются по таймауту |
принудительное создание кластера из одного участника |
Patroni |
недоступен, так как использует etcd |
ничего, восстанавливается после etcd |
OpenSearch |
недоступен, кворум узлов выбора потерян |
принудительный выбор управляющего узла |
API OpenStack |
ошибки 500 |
восстанавливается после RabbitMQ и ввода узлов |
Примечание
Отказ rabbit — основная причина недоступности API: параметр
cluster_partition_handling = pause_minority останавливает приложение на узле,
оказавшемся в меньшинстве. База данных при этом продолжает работать.
Подготовка
Определите уцелевший узел и убедитесь, что он доступен по SSH.
Подключитесь к уцелевшему узлу по SSH под ТУЗ.
Определите движок контейнеров региона (параметр
kolla_container_engine) — см. Оценка состояния кластера. Далее команды приведены во вкладках Docker и Podman.Создайте снимок etcd на уцелевшем узле. Снимок не создаётся заданием
backup-db, поэтому его требуется получить вручную. Сохраните файл вне каталога данных etcd:$ sudo docker exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; \ etcdctl snapshot save /tmp/etcd-before-recovery.db' $ sudo docker cp etcd:/tmp/etcd-before-recovery.db /home/kolla/
$ sudo podman exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; \
    etcdctl snapshot save /tmp/etcd-before-recovery.db'
$ sudo podman cp etcd:/tmp/etcd-before-recovery.db /home/kolla/
Предупреждение
Не оставляйте файл снимка в каталоге данных etcd (
/var/lib/etcd): при запуске etcd записывает в журнал предупреждениеfound invalid file under data directory.Получите пароли, которые потребуются далее, из Vault по пути
<vault_prefix>/<имя региона>/passwords_yml:etcd_cluster_token— для ввода узлов в кластер etcd.
Примечание
Задание backup-db прерывается, если кворум Galera уже потерян, поэтому создать резервную копию базы данных во время аварии не получится. Используйте копию, созданную по расписанию до отказа.
Восстановление кворума на уцелевшем узле
Все команды этого раздела выполняются на уцелевшем узле. Порядок обязателен: Patroni восстанавливается только после etcd, а ввод узлов возможен только после восстановления кворума во всех кластерах.
Управление контейнерами
Важно
Контейнеры управляются systemd (quadlet), поэтому команда podman stop или
docker stop не останавливает контейнер: служба запускает его заново. Используйте
systemctl:
$ sudo systemctl stop kolla-<имя-контейнера>-container.service
$ sudo systemctl start kolla-<имя-контейнера>-container.service
Кроме того, том и контейнер могут иметь одинаковое имя (например, etcd), поэтому
для получения параметров контейнера используйте podman container inspect, а не
podman inspect.
Кластер RabbitMQ
Приложение rabbit остановлено, поэтому команда forget_cluster_node недоступна:
режим --offline требует остановки всего узла Erlang, что невозможно внутри контейнера.
Временно измените режим обработки разделения кластера.
Сохраните конфигурацию и замените режим:
$ sudo cp -a /opt/kolla/rabbitmq/rabbitmq.conf /opt/kolla/rabbitmq/rabbitmq.conf.orig
$ sudo sed -i 's/^cluster_partition_handling = pause_minority/cluster_partition_handling = ignore/' \
    /opt/kolla/rabbitmq/rabbitmq.conf
Перезапустите RabbitMQ и дождитесь запуска приложения:
$ sudo systemctl restart kolla-rabbitmq-container.service
Удалите отказавшие узлы из кластера:
$ sudo docker exec rabbitmq rabbitmqctl forget_cluster_node rabbit@<узел-1>
$ sudo docker exec rabbitmq rabbitmqctl forget_cluster_node rabbit@<узел-2>
$ sudo podman exec rabbitmq rabbitmqctl forget_cluster_node rabbit@<узел-1>
$ sudo podman exec rabbitmq rabbitmqctl forget_cluster_node rabbit@<узел-2>
Примечание
Команда может не вернуть управление, хотя узел уже исключён. Результат проверяйте командой
rabbitmqctl cluster_status, зависшую команду прерывайте по Ctrl+C.Верните исходную конфигурацию и перезапустите RabbitMQ. Кластер состоит из одного узла, поэтому он остаётся в большинстве и приложение продолжает работать:
$ sudo cp -a /opt/kolla/rabbitmq/rabbitmq.conf.orig /opt/kolla/rabbitmq/rabbitmq.conf
$ sudo systemctl restart kolla-rabbitmq-container.service
Кластер etcd
Кворум потерян, поэтому удалить отказавших участников штатно невозможно. Создайте кластер из одного участника, сохранив данные.
Подготовьте файл переменных окружения на основе действующего контейнера и добавьте принудительное создание кластера:
$ sudo podman container inspect etcd \
    --format '{{range .Config.Env}}{{println .}}{{end}}' \
    | grep -E '^(ETCD_|ETCDCTL_|KOLLA_)' > /home/kolla/etcd-force.env
$ echo "ETCD_FORCE_NEW_CLUSTER=true" >> /home/kolla/etcd-force.env
Остановите штатный контейнер и запустите временный с тем же образом, теми же томами и подготовленным файлом переменных:
$ sudo systemctl stop kolla-etcd-container.service
$ sudo podman run -d --name etcd_force --network host \
    --env-file /home/kolla/etcd-force.env \
    -v kolla_etcd:/var/lib/etcd -v etcd_etc_etcd:/etc/etcd \
    -v etcd_etc_pki:/etc/pki -v etcd_etc_ssl:/etc/ssl \
    -v etcd_var_log:/var/log -v etcd_etc_kolla_defaults:/etc/kolla/defaults \
    -v etcd_var_lib_kolla_share:/var/lib/kolla/share \
    -v /opt/kolla/etcd:/var/lib/kolla/config_files/:ro \
    <docker_fqdn>/project_k/etcd:ks2026.2.1-sberlinux kolla_start
где
docker_fqdn— полное доменное имя сервисаdocker.<lcm_name>.vm.lab.itkey.com.Убедитесь по журналу временного контейнера, что участники удалены и узел стал лидером — строки
removed memberиbecame leader:$ sudo podman logs etcd_force 2>&1| grep -E "removed member|became leader"
Остановите временный контейнер и запустите штатный:
$ sudo podman stop etcd_force && sudo podman rm -f etcd_force
$ sudo systemctl start kolla-etcd-container.service
Убедитесь, что кластер состоит из одного участника и работоспособен:
$ sudo podman exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; etcdctl member list'
$ sudo podman exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; etcdctl endpoint health'
Убедитесь, что кластер Patroni восстановился — узел перешёл в роль
Leader:$ sudo podman exec patroni patronictl -c /etc/patroni/patroni.yml list
Кластер Galera
Galera переживает потерю двух узлов, если они выводились штатно: уцелевший узел
пересчитывает состав кластера при каждом выходе участника и сохраняет состояние
Primary. В этом случае никаких действий не требуется.
Проверьте состояние кластера на уцелевшем узле:
$ sudo docker exec mariadb /usr/bin/clustercheck

Galera cluster node is synced.
$ sudo podman exec mariadb /usr/bin/clustercheck

Galera cluster node is synced.
Проверьте
wsrep_cluster_status=Primaryна уцелевшем узле:$ sudo podman exec mariadb sh -c 'mysql -uroot \ -p<MYSQL_PASSWORD> -h localhost -N -B \ -e "SHOW GLOBAL STATUS WHERE Variable_name IN \ (\"wsrep_cluster_size\",\"wsrep_cluster_status\",\"wsrep_local_state_comment\")"'
где
<MYSQL_PASSWORD>— значение ключаdatabase_passwordизpasswords_ymlвашего региона в Vault.Если состояние —
Primary, перейдите к следующему разделу: база данных работает, восстановление не требуется.Если состояние —
non-Primary(возможно при аварийном отключении узлов, а не при штатном выводе), переведите уцелевший узел в режим самостоятельного кластера:$ sudo podman exec mariadb sh -c 'mysql -uroot -p<MYSQL_PASSWORD> \ -h localhost -e "SET GLOBAL wsrep_provider_options='\''pc.bootstrap=YES'\'';"'
где
<MYSQL_PASSWORD>— значение ключаdatabase_passwordизpasswords_ymlвашего региона в Vault.
Опасно
Задание mariadb-recovery неприменимо, пока отказавшие узлы не возвращены в
строй:
с ограничением
KOLLA_ARGS=--limit <узел>задание завершается ошибкой'ansible.vars.hostvars.HostVarsVars object' has no attribute 'hostname': playbookmariadb_recovery.ymlне собирает факты об узлах вне ограничения, а шаблоны роли обращаются к именам всех узлов группыmariadb;без ограничения задание затрагивает переустановленные узлы, на которых ещё нет образов и конфигурации MariaDB.
Запускайте mariadb-recovery только после возвращения узлов в кластер — например,
если после ввода узлов кластер Galera не собрался.
Переустановка и ввод узлов
Переустановите оба узла — процедура не отличается от замены одного узла, оба узла можно указать в одном запуске пайплайна.
Выполните подготовку узлов заданиями
bootstrap-serversиhost-configс ограничением на оба переустановленных узла:Откройте веб-интерфейс развёрнутого GitLab.
Перейдите в репозиторий project_k / deployments / <имя региона>.
Создайте новый пайплайн: .
В открывшемся окне укажите значение переменной
KOLLA_ARGSравное--limit <узел-1>,<узел-2>.Запустите пайплайн New pipeline.
Дождитесь завершения задачи setup.
Запустите задачу bootstrap-servers.
Дождитесь завершения выполнения задачи.
Запустите задачу host-config.
Дождитесь завершения выполнения задачи.
Создайте конфигурацию сервисов на переустановленных узлах: запустите пайплайн региона с переменными
KOLLA_ANSIBLE_DEPLOY_ACTION=genconfigиKOLLA_ARGS=-t etcd,haproxy --limit <узел-1>,<узел-2>.Введите узлы в кластер etcd по одному.
Опасно
Узлы добавляются строго последовательно: пока добавленный участник не запущен, кластер из двух участников не имеет кворума, и добавление второго завершается ошибкой
etcdserver: re-configuration failed due to not enough started members.Примечание
Ввод узлов в кластер etcd до развёртывания обязателен ещё и потому, что при непустом каталоге данных роль
etcdсчитает узел действующим участником и не пытается создать кластер заново. Если запустить развёртывание раньше, узел поднимет собственный кластер из одного участника.На уцелевшем узле добавьте участника. Команда выводит переменные окружения, которые потребуются на следующем шаге:
$ sudo podman exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; \
    etcdctl member add <имя-узла> --peer-urls=https://<IP-адрес узла>:2380'
Примечание
После добавления участника уцелевший узел временно теряет кворум: в кластере из двух участников запущен только один. Обращения
etcdctlзавершаются по таймауту до запуска нового участника — это ожидаемое состояние, повторно создавать кластер не требуется.На вводимом узле подготовьте файл переменных окружения
/home/kolla/etcd-force.env. Кроме значений из выводаmember addукажите адреса узла,ETCD_DATA_DIR,ETCDCTL_API,ETCDCTL_ENDPOINTS,ETCD_INITIAL_CLUSTER_TOKENиз Vault и параметрKOLLA_CONFIG_STRATEGY:KOLLA_CONFIG_STRATEGY=COPY_ALWAYS ETCD_NAME=<имя-узла> ETCD_INITIAL_CLUSTER=<из вывода member add> ETCD_INITIAL_ADVERTISE_PEER_URLS=https://<IP-адрес узла>:2380 ETCD_INITIAL_CLUSTER_STATE=existing ETCD_INITIAL_CLUSTER_TOKEN=<etcd_cluster_token из Vault> ETCD_DATA_DIR=/var/lib/etcd ETCD_LISTEN_CLIENT_URLS=https://<IP-адрес узла>:2379 ETCD_ADVERTISE_CLIENT_URLS=https://<IP-адрес узла>:2379 ETCD_LISTEN_PEER_URLS=https://<IP-адрес узла>:2380 ETCD_CERT_FILE=/etc/etcd/certs/etcd-cert.pem ETCD_KEY_FILE=/etc/etcd/certs/etcd-key.pem ETCD_TRUSTED_CA_FILE=/etc/pki/tls/certs/ca-bundle.crt ETCD_PEER_CERT_FILE=/etc/etcd/certs/etcd-cert.pem ETCD_PEER_KEY_FILE=/etc/etcd/certs/etcd-key.pem ETCD_PEER_TRUSTED_CA_FILE=/etc/pki/tls/certs/ca-bundle.crt
где
<имя-узла>— название уцелевшего узла.<etcd_cluster_token из Vault>— токен для ввода узлов в кластер etcd из Vault по пути<vault_prefix>/<имя региона>/passwords_yml.<из вывода member add>— значение параметраETCD_INITIAL_CLUSTER, полученное на первом шаге.<IP-адрес узла>— IP-адрес уцелевшего узла.
Запустите временный контейнер etcd на вводимом узле:
$ sudo systemctl stop kolla-etcd-container.service
$ sudo podman run -d --name etcd_force --network host \
    --env-file /home/kolla/etcd-force.env \
    -v kolla_etcd:/var/lib/etcd -v etcd_etc_etcd:/etc/etcd \
    -v etcd_etc_pki:/etc/pki -v etcd_etc_ssl:/etc/ssl \
    -v etcd_var_log:/var/log -v etcd_etc_kolla_defaults:/etc/kolla/defaults \
    -v etcd_var_lib_kolla_share:/var/lib/kolla/share \
    -v /opt/kolla/etcd:/var/lib/kolla/config_files/:ro \
    <docker_fqdn>/project_k/etcd:ks2026.2.1-sberlinux kolla_start
где
docker_fqdn— полное доменное имя сервисаdocker.<lcm_name>.vm.lab.itkey.com.Убедитесь, что участник перешёл в состояние
started, а все конечные точки кластера работоспособны, и остановите временный контейнер:$ sudo podman exec etcd sh -c 'unset ETCDCTL_WRITE_OUT; etcdctl endpoint health --cluster' $ sudo podman stop etcd_join && sudo podman rm -f etcd_join
Повторите шаги для второго узла, указав корректные значения параметров в переменных окружения.
Примечание
Значения параметра
ETCD_INITIAL_CLUSTERдля первого и второго узлов будут различаться.Выполните развёртывание на всю группу управляющих узлов:
На уцелевшем узле остановите контейнер
keystone_fernet:$ systemctl stop kolla-keystone_fernet-container.service
Откройте веб-интерфейс развёрнутого GitLab.
Перейдите в репозиторий project_k / deployments / <имя региона>.
Создайте новый пайплайн: .
В открывшемся окне укажите значение переменной
KOLLA_ARGSравное-e mariadb_ssl_status=YES --limit control --skip-tags opensearch.Запустите пайплайн New pipeline.
Дождитесь завершения задачи setup.
Запустите задачу deploy.
Дождитесь завершения выполнения задачи.
Создайте новый пайплайн: .
В открывшемся окне добавьте переменную
PLEASE_CALL_VENDORсо значениемtrue.Запустите пайплайн New pipeline.
Дождитесь завершения задачи setup.
Запустите задачу rabbitmq-reset.
Дождитесь завершения выполнения задачи.
Восстановление кластера OpenSearch
Конфигурация голосования уцелевшего узла содержит идентификаторы отказавших узлов, поэтому
управляющий узел не может быть выбран. В журнале
(/var/log/kolla/opensearch/<имя-кластера>.log) повторяется сообщение
cluster-manager not discovered or elected yet.
Остановите OpenSearch на уцелевшем узле:
$ sudo systemctl stop kolla-opensearch-container.service
На уцелевшем узле выполните принудительный выбор управляющего узла:
$ printf 'y\n' | sudo podman run --rm -i --network host \
    -v opensearch:/var/lib/opensearch/data \
    -v opensearch_etc_opensearch:/etc/opensearch \
    -v opensearch_var_log_opensearch:/var/log/opensearch \
    -v kolla_logs:/var/log/kolla \
    -v opensearch_etc_pki:/etc/pki -v opensearch_etc_ssl:/etc/ssl \
    --entrypoint '["/usr/share/opensearch/bin/opensearch-node","unsafe-bootstrap"]' \
    <docker_fqdn>/project_k/opensearch:ks2026.2.1-sberlinux
где
docker_fqdn— полное доменное имя сервисаdocker.<lcm_name>.vm.lab.itkey.com.Запустите OpenSearch на уцелевшем узле и подождите 3 минуты.
$ sudo systemctl start kolla-opensearch-container.service
Запустите OpenSearch на добавляемых узлах:
Откройте веб-интерфейс развёрнутого GitLab.
Перейдите в репозиторий project_k / deployments / <имя региона>.
Создайте новый пайплайн: .
В открывшемся окне укажите значение переменной
KOLLA_ARGSравное-t opensearch --limit <узел-1>,<узел-2>.Запустите пайплайн New pipeline.
Дождитесь завершения задачи setup.
Запустите задачу deploy.
Дождитесь завершения выполнения задачи.
Примечание
Пайплайн завершится ошибкой, это нормально, важно дождаться завершения задачи Restart opensearch container.
Удалите только те индексы, у которых основной шард остался нераспределённым (
prirep=p, состояниеUNASSIGNED, причинаCLUSTER_RECOVERED): их данные размещались только на отказавших узлах и не восстанавливаются. Из-за них кластер остаётся в состоянииred, а заданиеdeployв предыдущем пункте завершается ошибкой:Получите список индексов на удаление:
$ sudo podman exec opensearch curl -s -k \
    --cert /etc/opensearch/opensearch-cert.pem \
    --key /etc/opensearch/opensearch-key.pem \
    "https://localhost:9200/_cat/indices?h=health,index" | grep -v "^green"
Для каждого индекса выполните команду на удаление:
$ sudo podman exec opensearch curl -s -k \
    --cert /etc/opensearch/opensearch-cert.pem \
    --key /etc/opensearch/opensearch-key.pem \
    -X DELETE "https://localhost:9200/<индекс>"
где
<индекс>— имя индекса из предыдущей команды.Приведите кластер OpenSearch в консистентное состояние:
Откройте веб-интерфейс развёрнутого GitLab.
Перейдите в репозиторий project_k / deployments / <имя региона>.
Создайте новый пайплайн: .
В открывшемся окне укажите значение переменной
KOLLA_ARGSравное-t opensearch --limit control.Запустите пайплайн New pipeline.
Дождитесь завершения задачи setup.
Запустите задачу deploy.
Дождитесь завершения выполнения задачи.
Примечание
Объём потерянных данных зависит от того, на каких узлах располагались основные шарды, и заранее неизвестен: при проверке процедуры в одном случае были потеряны журналы за два дня, в другом — за четыре дня и индекс
.kibana_1с настройками панелей.Восстановление работы индексации OpenSearch:
Перейдите в Портале администратора в раздел .
При первом входе после восстановления OpenSearch направит вас на страницу создания шаблонов.
Нажмите кнопку Create index pattern.
В появившемся окне в поле Index pattern name укажите
flog*и нажмите Next Step.В поле Time field выберите из выпадающего списка
@timestampи нажмите Create index pattern.
Проверка результата
Перейдите в веб-интерфейс Портала администратора.
Авторизуйтесь, используя учётную запись с ролью admin. При успешной установке отобразится общий дашборд платформы.
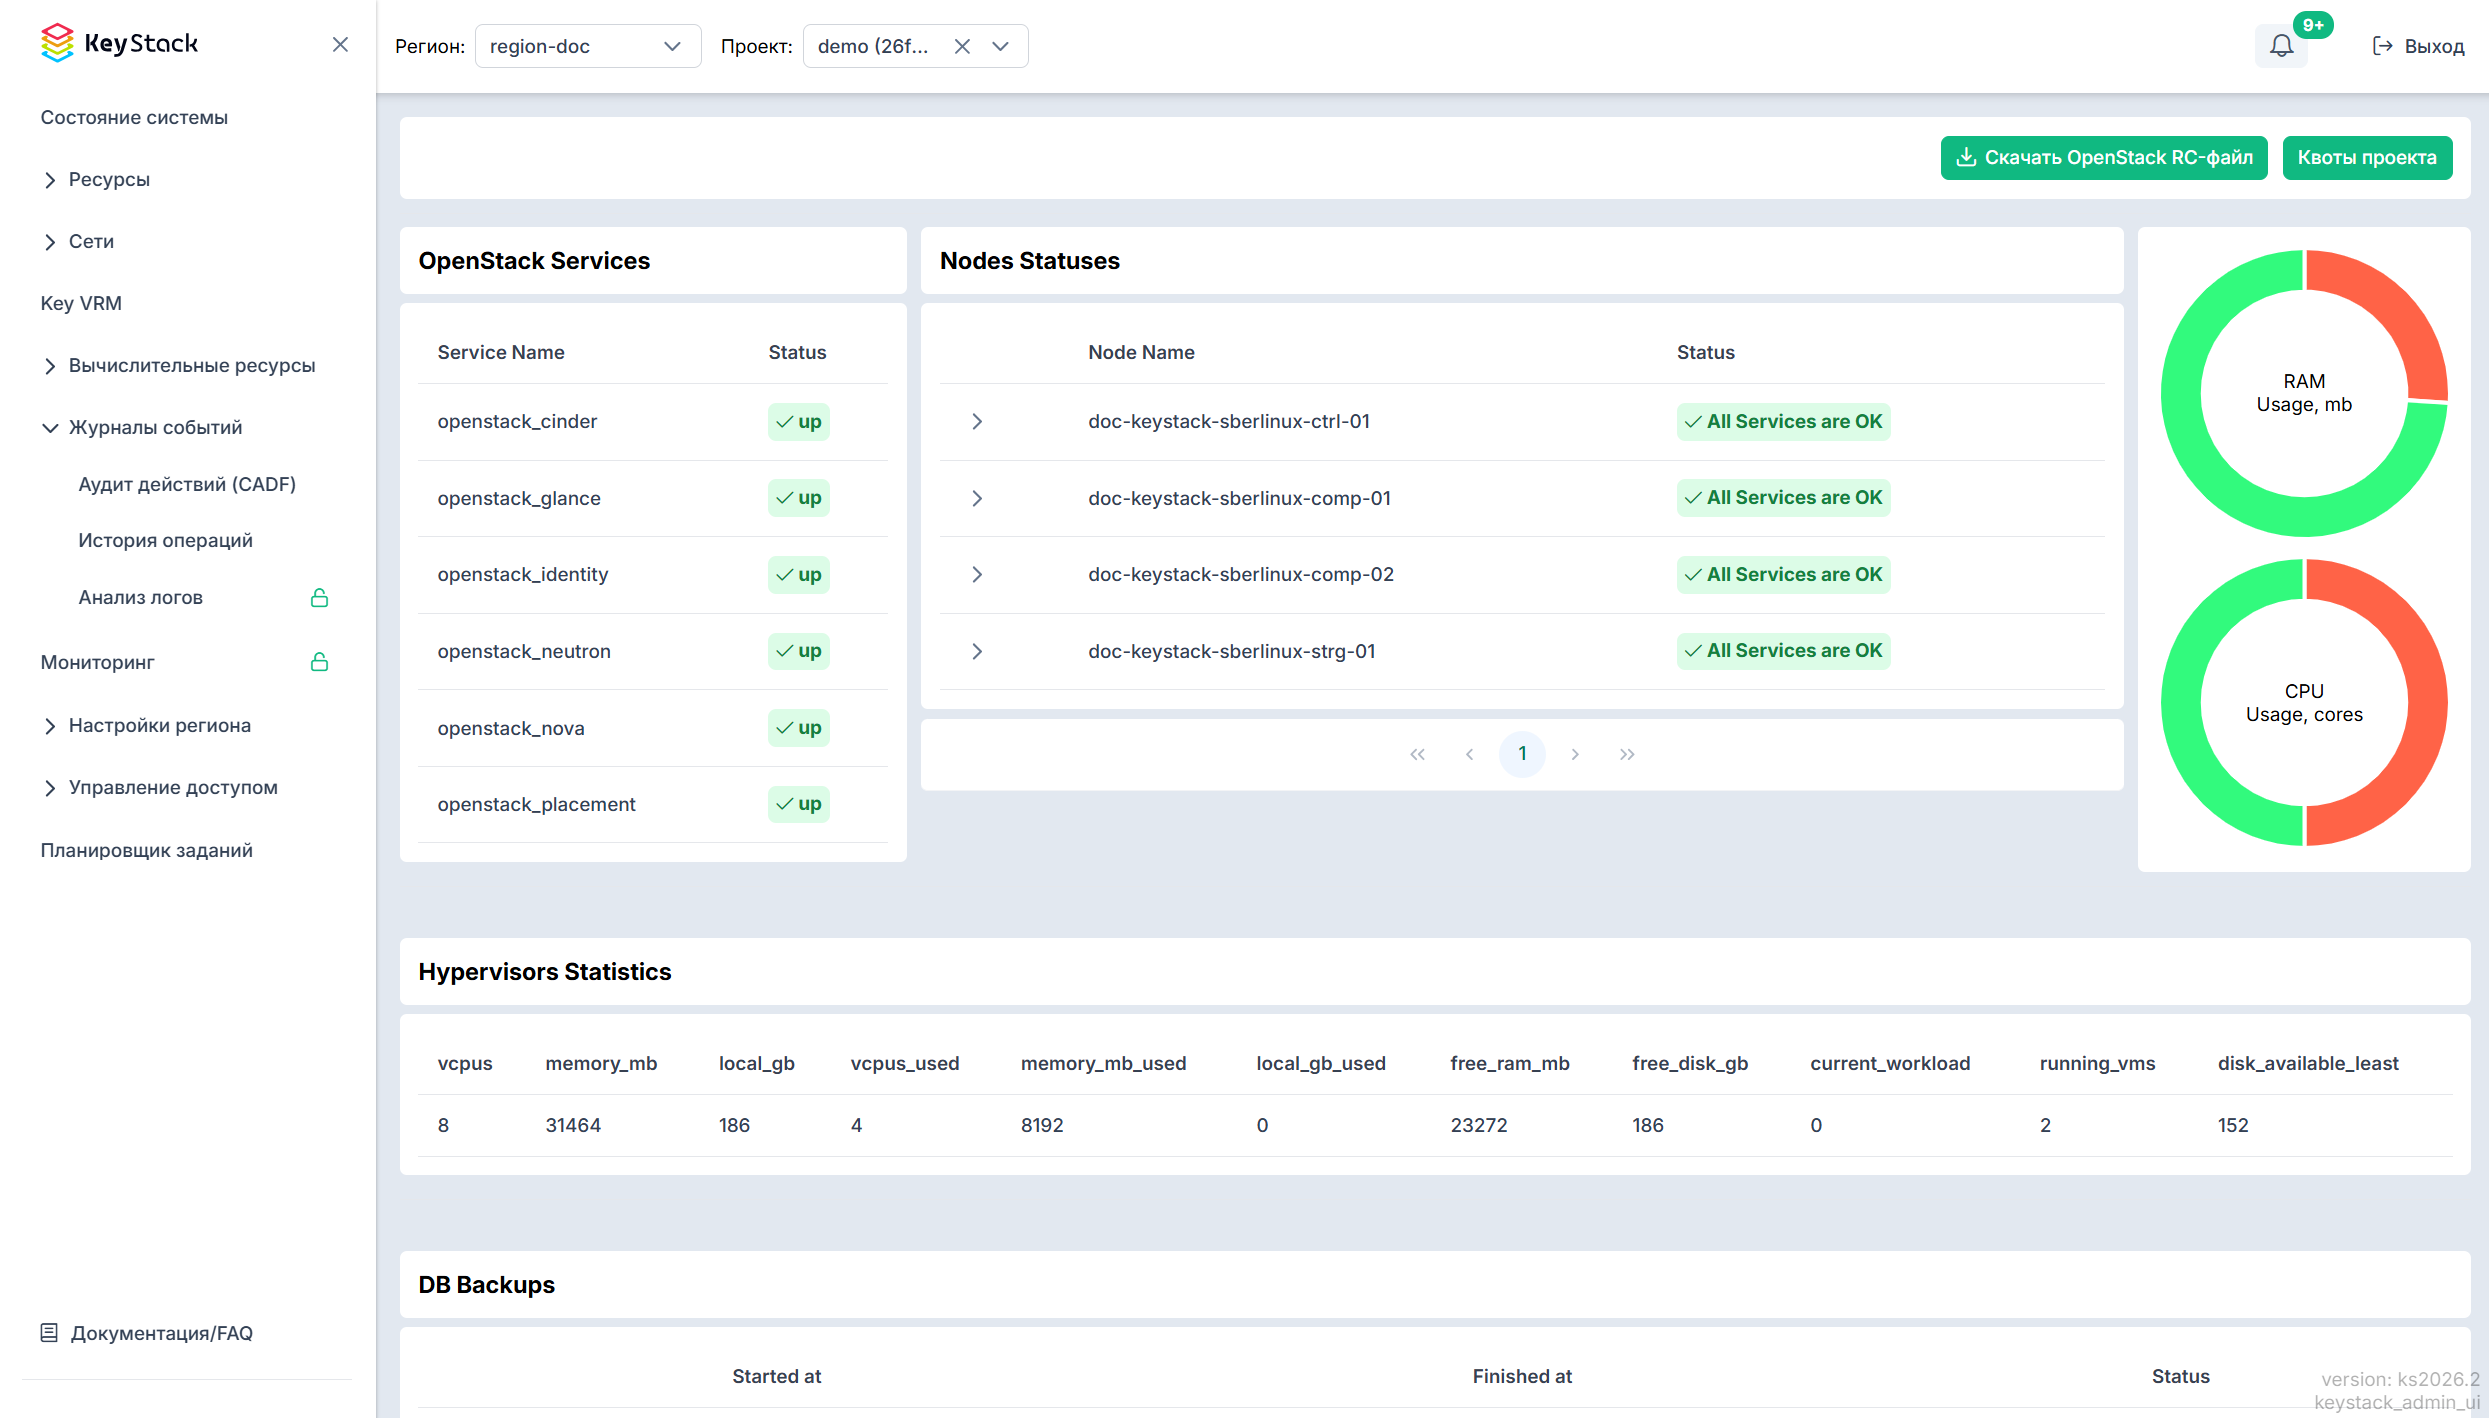
Состояние системы на Портале администратора
Убедитесь, что все сервисы и узлы в состоянии
up/OK.Если состояние сервисов не соответствует
up/OK, выполните следующие действия:Перейдите в раздел .
Из выпадающего списка Имя хоста выберите необходимый узел.
Из выпадающего списка Docker, Systemd, Podman выберите
Systemd.Из выпадающего списка Команда выберите команду
restart.Из выпадающего списка Идентификатор/Наименование выберите наименование службы, которое начинается с
kolla-.Нажмите кнопку Выполнить для запуска команды.
Проверьте базовую функциональность региона: создайте виртуальную машину, том Cinder и выполните миграцию виртуальной машины.