Слой управления виртуализации
Слой управления виртуализации (Control Plane) принимает запросы к ресурсам региона и координирует работу вычислительных, сетевых сервисов и сервисов хранения.
Слой управления состоит из следующих компонентов:
Управляющие сервисы OpenStack:
Identity (Keystone) — сервис идентификации и управления доступом:
keystone-server;Compute (Nova) — сервис управления ВМ:
nova-api,nova-scheduler,nova-conductor;Cloud Resource Inventory (Placement) — сервис учёта ресурсов:
placement-api;Block Storage (Cinder) — сервис блочного хранения:
cinder-api,cinder-scheduler,cinder-volume(в базовой конфигурации),cinder-backup. Подробнее о компоненте и его драйверах см. в разделе Cinder — Блочное хранилище;Networking (Neutron) — сервис управления виртуальными сетями:
neutron-server;Image (Glance) — сервис управления образами ВМ:
glance-api;Key Manager (Barbican) — сервис управления секретами, ключами и сертификатами:
barbican-server.
MariaDB — сервис баз данных;
RabbitMQ — сервис передачи сообщений;
KeyVRM — сервис управления отказоустойчивостью и балансировкой нагрузки ВМ. Развёртывание и первичная настройка описаны в разделе Развёртывание и первичная настройка KeyVRM, управление сервисом — в разделе Управление KeyVRM;
Сервисы мониторинга:
VictoriaMetrics — хранение данных мониторинга. Устройство и настройка сервиса описаны в разделе VictoriaMetrics;
Grafana — визуализация данных мониторинга. Описание и установка сервиса приведены в разделе Сервис визуализации данных.
Установка и настройка сервисов мониторинга описана в разделе Настройка мониторинга и аудита региона.
OpenSearch — сервис хранения журналов. Подробнее о сервисе см. в разделе OpenSearch — Логирование и поиск;
Сервис маршрутизации и фильтрации запросов API;
Агенты систем мониторинга и журналирования —
fluentd,prometheus-node-exporter,prometheus-blackbox-exporter,prometheus-openstack-exporter.
Организация отказоустойчивости слоя управления
Для отказоустойчивости поддерживающих кластеризацию сервисов (MariaDB и RabbitMQ) используются встроенные механизмы построения кластеров на основе кворумного алгоритма.
Отказоустойчивость управляющих сервисов OpenStack обеспечивается использованием не менее трёх экземпляров каждого сервиса и встроенных в операционную систему механизмов восстановления аварийно завершившихся процессов. Сервисы, обслуживающие запросы REST API, объединены под балансировщиком нагрузки HAProxy.
Примечание
Для кластера MariaDB используется балансировщик нагрузки ProxySQL.
Доступность виртуальных IP-адресов (VIP) балансировщиков HAProxy и ProxySQL обеспечивается одним из двух способов: протоколом VRRP с использованием Keepalived либо технологией BGP Anycast VIP с использованием Bird и ExaBGP.
При использовании VRRP и Keepalived принадлежность VIP узлу зависит от результатов проверки работоспособности сервисов.
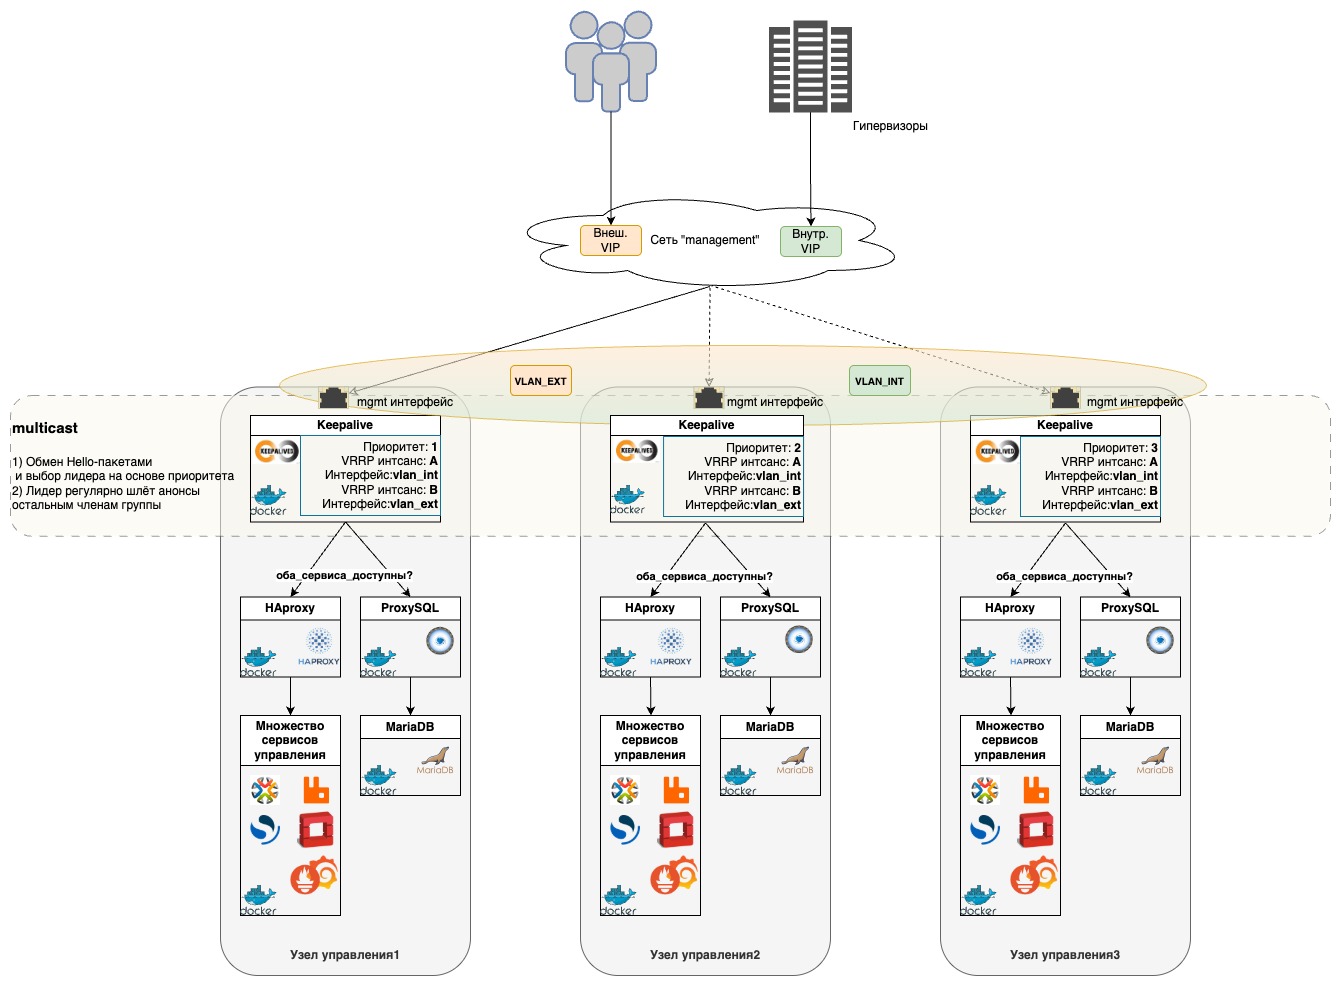
Организация балансировки нагрузки с использованием VRRP и Keepalived
При использовании BGP Anycast VIP, Bird и ExaBGP результаты проверки работоспособности сервисов определяют, анонсируется ли маршрут к VIP в сеть передачи данных.
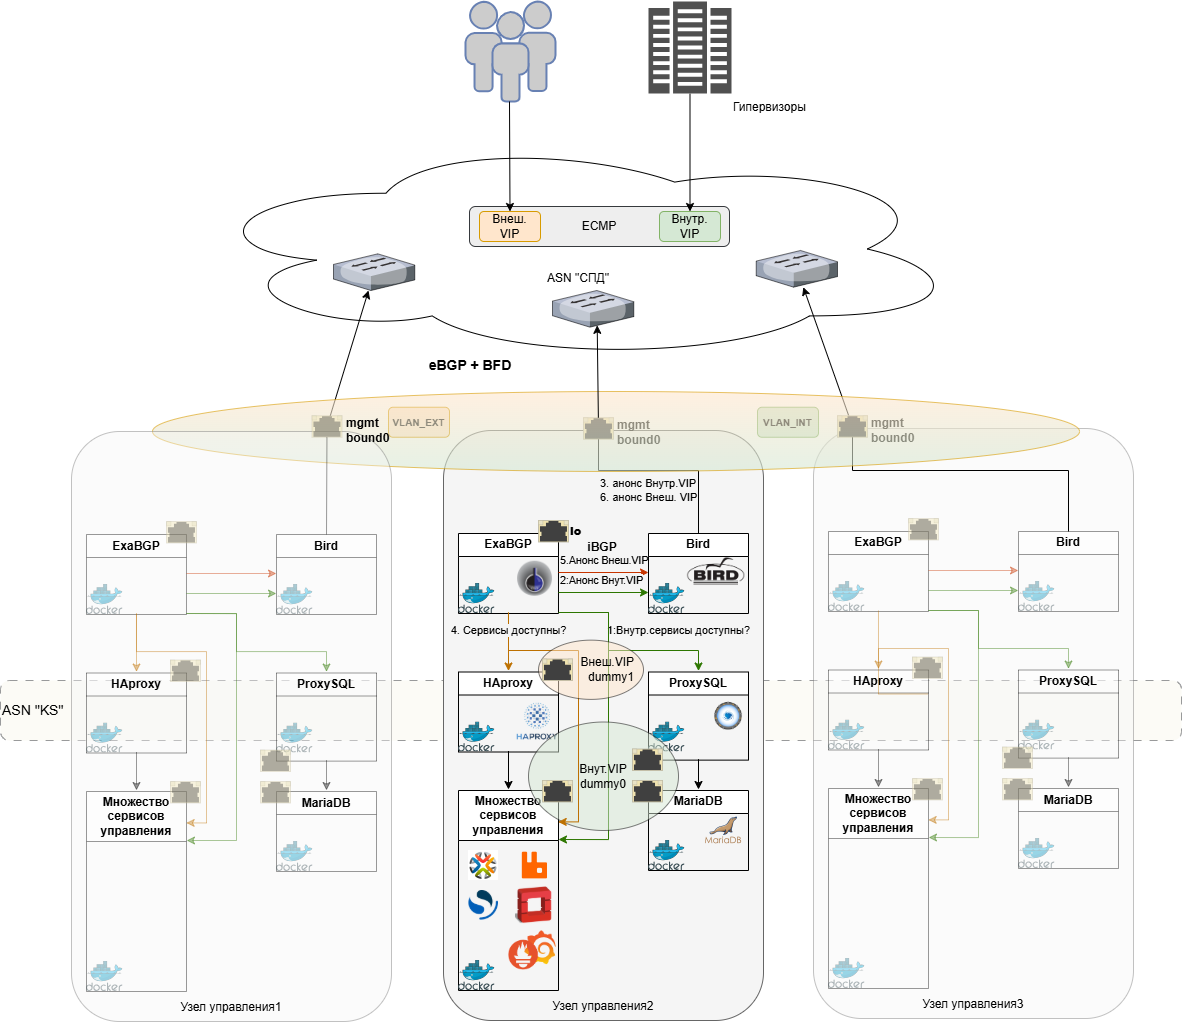
Организация балансировки нагрузки с использованием BGP Anycast VIP, Bird и ExaBGP
Принципы масштабирования слоя управления
Слой управления виртуализации возможно масштабировать — способ масштабирования зависит от того, какие компоненты ограничивают производительность платформы:
При увеличении активности сервисов платформы растёт объём журналов и данных мониторинга. В этом случае VictoriaMetrics и OpenSearch переносятся на дополнительные выделенные серверы.
При увеличении объёма трафика между ВМ и внешними сетями роль сетевого узла (Network) может быть перенесена на отдельные выделенные серверы. В дальнейшем их количество можно увеличивать.
При увеличении количества запросов к сервисам блочного хранения
cinder-volumeиcinder-backupмогут быть перенесены на отдельные выделенные узлы хранения (Storage).